Vibe Coding的心法
一位微信好友,分享了一份他们团队目前在做的事情,发来一份文档,我提炼了下这份文档里关于Vibe Coding的一些观点和心法,团队是前nasa科学家和comcast工程师,很有启发:
- AI越来越强,但AI创造的软件,反而越来越难以被信任
- 模型独立,不代表判断独立,AI时代真正的瓶颈,变成了人的判断力,从软件工程视角,真正稀缺的能力会变成:定义问题、选择方向、制定标准、判断结果
- 代码和测试可以完全一致,结果依然可能是错的,这是因为,AI答案和评测标准高度一致,也可能一起建立在错误的问题定义之上,所以,我们还有一个很重要的需要关注的问题:我们解决的是正确的问题吗?
- 目前AI一个最大的问题,会很容易基于一个错误的答案,自己验证,自己通过,然后制造一种危险的确定感,错误+验证通过,比单纯的错误更危险
- 换一个模型,并不天然意味着获得了独立审查,现在很多人的AI Review方法是:Claude写完,然后GPT Review,看起来已经交叉验证。但如果GPT看到的是Claude已经写好的PRD、推理和结论,它很容易被前面的框架锚定,所以真正的多Agent协作应该考虑“信息独立性”
- 先独立思考,再比较收敛。先让不同的AI独立思考,再互相比较,不要让5个Agent一上来就讨论,有价值的多Agent讨论,来自独立信息路径
- 什么能够证明这件事情成功了?也就是定义成功的标准是什么?做事之前先回答:什么证据证明成功
- 项目的流程,每一个关口都要有证据,不能等到最终交付才验证,比如需求、定义、设计、开发、验证、交付,每一个环节,都需要有对成功的定义
- 客户应该购买结果,而不是自己拼一堆工具,比如,不需要对用户表达那么多的Agent、MCP、API、工作流等等,只需要表达一个目标,一套系统,一个可验证结果
- 每一次经过验证的交付,都让下一次交付变得更好,定义了一个真正的AI原生组织应该具备的能力:组织不能只是完成任务,还必须从每一次任务中学习
- 一个真正的AI员工,每完成一次任务,都应该让下一次同类任务做得更好
这套心法,总结起来就是:先定义正确的问题,再独立形成判断;先定义成功证据,再开始执行;过程中持续验证,完成后沉淀经验,让下一次做得更好
第二届GEO大会
第二届GEO大会,报名后,可以提交自己关心的问题,到时候会把这些问题,分享给大会的嘉宾,以帮助他们更好的优化自己的分享主题
目前后台收到的一些问题,我看了下,还挺有价值的
问题大致有这几类:
- 效果怎么衡量
比如ToB的GEO,ROI怎么算?多久能见效?监测工具如何评价?哪些指标可以作为交付依据?
- GEO项目,在企业怎么推进?
哪个部门牵头?大企业和中小企业的策略有何不同?预算有限时,先做什么、后做什么?
- GEO的内容,如何让AI建立信任?
不同AI平台如何选择信源?大量分发如何避免过度营销?律师案例怎样兼顾脱敏、可信度与可引用性?
- 外贸行业做GEO怎么获得询盘?
海外GEO怎么做?工业企业的独立站如何被AI引用,并引导采购客户访问网站、留下询盘?
- Agent与GEO如何联动
AI引用与Agent分发怎样衔接?不同渠道的线索如何区分?询盘怎么追踪,获客成本怎么算?
这些问题已经把GEO放进了具体的经营语境里
谁来做、怎么推进、如何验证、能带来什么结果,都需要说清楚
意图覆盖率
一位X网友的问题:
GEO如何去找到最应该优化的用户query呢? 我的衡量标准是得找到最多用户问的query,但是这个很难得到吧? 1.除了模型公司内部,没人知道 2. 每个人问的具体格式千奇百怪。比如我要一个鞋子,推荐一个鞋子,一双鞋子推荐给我。这3种表达的意思是一样的。 该如何去找最多人问的query呢?
我的回答:
外部通常拿不到AI平台完整的query日志
也就很难准确的证明,某一句话就是用户问得最多的问题
其中一个思路是:将GEO的优化单位,从单条query变成意图组
比如“推荐一双鞋”“给我推荐个鞋子”“什么鞋适合我”,表达不同,但可以归为同一个推荐决策意图
可以先根据场景、人群、需求、痛点、预算、品牌对比、信任验证和购买决策等维度,建立一套商业意图地图,再为每个意图扩展多种自然问法
数据来源可以结合搜索词、客服记录、销售沟通、站内搜索、电商问答、社交媒体和竞品内容,再用AI完成聚类、去重和问句扩展
这个工作有它的繁琐性和系统性
最终可以衡量两个指标:
第一是“加权意图覆盖率”,看品牌覆盖了多少高价值意图。不同意图的权重,可以结合真实需求证据、商业价值、决策距离和品牌适配度确定
第二是“问法鲁棒性”,看同一个意图换一种表达后,品牌还能不能稳定出现
我们很难获得绝对准确的AI搜索量,但可以建立一套有真实数据支撑、持续更新,并且能够指导业务决策的意图需求地图
一位X友的补充:
很认同姚老师从“单条 Query”往“意图归类”走,这应该比追求某一句用户问得最多的问题更接近实际。
我们在实战里现在也是类似思路。面对大量 Prompt 和 AI 回答,不直接把每一种措辞当成一个新的需求,而是先做语义去重和归类,再从回答中抽取细分市场、搜索意图、品牌卖点、品牌、引用这些结构化维度,最后还可以回到原始 AI 回答验证。下面这张图是意图归类举例
不过实际做下来,我觉得真正难的可能还不是“怎么聚类”,而是怎么建立正确的分类层级。
最近一个户外品牌项目。同样是“帐篷”,车尾帐、冬季热帐、精致露营帐的用户场景、决策条件和关注卖点都完全不同。如果只是从语言相似度把它们归到一个大的“帐篷推荐”意图里,技术上聚类成功了,但对 GEO 优化未必有价值。
所以我们自己现在也在继续调整这套结构,我越来越倾向于:细分市场 → 搜索意图 / 品牌卖点 → 具体问法,同时再用多标签和交叉维度处理场景、人群、预算、购买阶段这些变量。
现在无法拿到完整的真实 Query 日志,所以我现在也反而不太追求一个看起来很精确的“AI 搜索量”。更重要的是能不能把足够大的观测数据,整理成一套有真实业务依据、可以回溯验证、最终能够指导优化的需求地图。
一个GEO项目的成交故事
昨晚接待了一位上市公司的CTO朋友,在北京的后海边,看着夜景,喝了点啤酒
他们从去年年初就开始GEO,算是国内非常早期关注到这个趋势的公司了
然后他就开始在内部推动这个事情
大概半年左右过去,终于内部达成共识,开始挑选供应商
这个过程,也是挺艰难的
最终,他们锁定了三家候选供应商:A、B、C
A在北京,B在上海,C在杭州
最终选择了跟A合作,放弃了B和C,合作金额大概一年接近100万
我问:原因是什么
他说:C更像是“GEO投毒”的做法,所以直接放弃;B相比A,其实有两个优势,一个是产品化水平高,一个是公司规模更大
我问:那为什么最终选择了A呢?
他说:选择A,主要有两个原因,一个是A的COO给他们分享宣讲时,更专业,认知更深,B的负责人分享时更空;二是A的价格相比B更有优势,但是产品化水平和公司规模与实力是劣势,内部综合讨论下来,还是A更好
他又继续补充:所以A当时的价格策略还是很明智,合理的有一定优势的定价,是很难得的事情
合作后,他们又做了一个很有意思的事情
在和A公司合作的同时,又与D合作,只买他们的GEO监测工具产品
CTO说:他们内部需要通过增加一套第三方工具,来对A的数据进行交叉验证,同时也借助第三方工具,来获得更多的有价值的信息
我说:这个策略很明智啊
两点收获:
- 专业认知 + 合理价格 > 产品化优势 + 公司规模优势
- 越重要的结果,越需要独立验证
但他们现在也面临新的一个课题或者难题,对于GEO整体而言,最终的贡献到底如何衡量?有哪些证据和数据归因方法,能够算出这个事的ROI?
AI Mention Effect
这是来自ProFound的一份关于AI Mention Effect的研究
研究的内容是:当用户原本没有主动搜索某个品牌,但AI在回答里提到了这个品牌,接下来7天,用户访问这个品牌官网的概率会发生什么变化
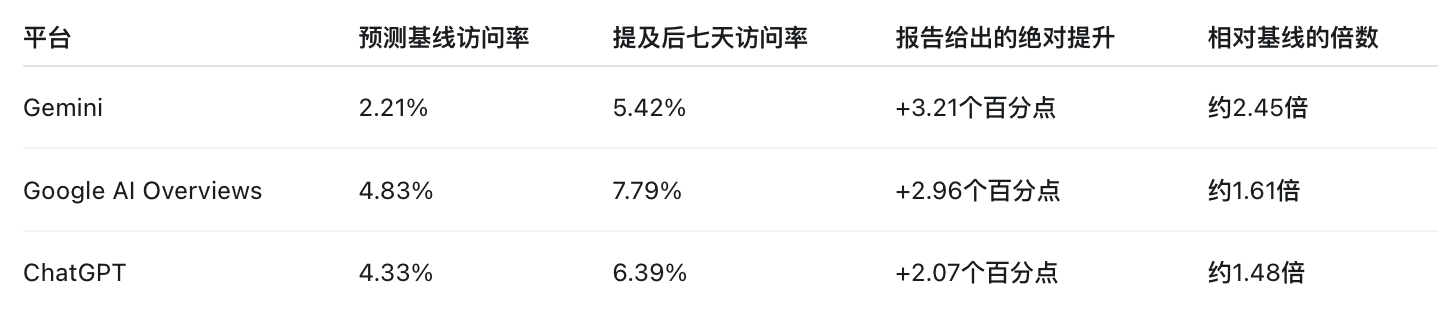
数据来自2026年1月至6月的200多万次AI对话及关联浏览记录,覆盖ChatGPT、Gemini和Google AI Overviews,研究将“提问未出现、AI回答出现”的品牌视为曝光
以Gemini为例,预测基线访问率只有2.21%,被AI提及之后变成5.42%,相当于原来的2.45倍
ChatGPT也从4.33%提升到了6.39%
具体数据如下:
如何理解这些数据
可以把这张表理解成一个非常简单的问题
同样是1000个潜在用户,如果AI没有主动提到这个品牌,预计多少人会访问官网?如果AI提到了,之后7天又有多少人访问官网?
这样看就更好理解了
对应的表格就变成了:
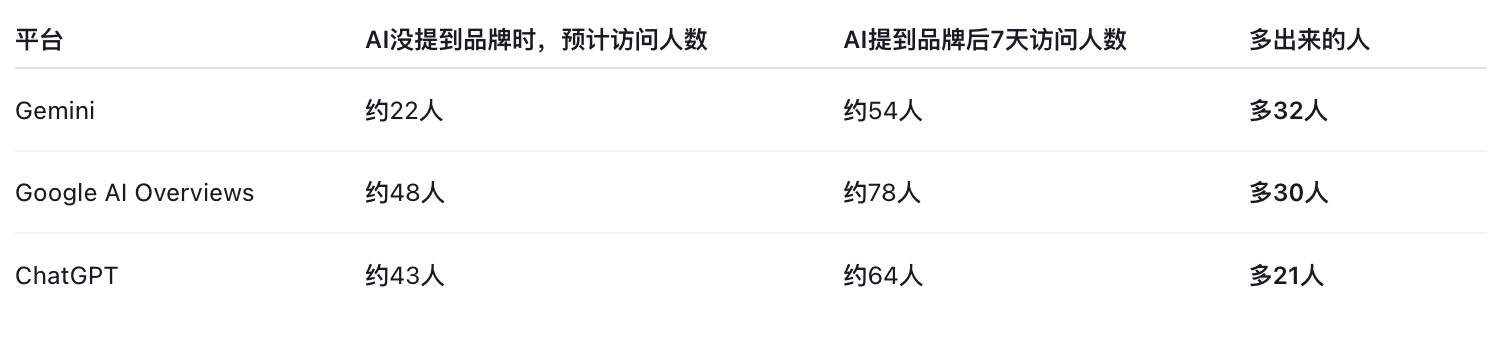
也就是,如果AI向潜在用户推荐过目标品牌,会对目标品牌的用户访问产生极大的增量价值
用户的一个行为特征是,AI提到品牌以后,用户未必马上点击链接
他可能当天记住这个名字,晚上去百度搜索,第二天访问官网,几天后再去看案例,最后才咨询
所以很多时候,我们在网站统计里看到的“百度流量”“直接访问”“品牌词搜索”,越来越多的证据表明,最早的起点可能来自一次AI回答里的推荐
这个数据可以帮助我们更直观的理解AI带来的数据与价值,当然,实际情况肯定要因企业而异,每家企业的情况都不一样
报告原文
慢中求快
周末去一位老朋友的公司
创始人给我说,这个月预计会亏损一百多万
原因有很多,核心原因总结下来就是,前期跑得太快,很多动作相对激进,团队不扎实、产品不扎实、服务不扎实,导致公司外强中干,虚胖得很厉害
我问,那接下来打算怎么办
他说,一方面把之前的坑快速填一下,然后就把各个核心模块的能力,做扎实一些,聚焦一下,走稳一点,不要那么着急了
后来,我们总结了几条心法,共勉:
- 我们看到的绝大部分的机会,其实,都不是我们的机会,所谓聚焦,只是在找到属于自己的机会面前持续做深而已
- 创始人的注意力相当重要,那些看似捡钱的但又在聚焦点之外的机会,其实都是一种注意力与资源的消耗
- 宁愿前慢后快,也不要前快后崩
- 一步一步做扎实,找准方向,定好边界,很重要,找准方向很多人都具备这个能力,但边界的把控,似乎会更难
Jev是什么
Jev是TypeSafe AI发布的首个公开模型,2026年9月15日开放访问
它是面向类型化语义决策的模型产品,这个模型一发布,便引起了极大的关注
如何理解这个新的模型?
可以把它理解成一个“会读材料、按标准做选择题的评审器”
比如:
假设每天收到一万条客户留言,通用聊天模型可以阅读留言、解释诉求、起草回复
Jev的能力非常聚焦:只判断这些留言,该交给哪个部门、紧急程度处于哪一档、是否需要人工处理,系统随后按这些结果执行既定流程
现在的大模型,已经有这个能力,只是相比之下,成本更高,概率质量更低,速度更慢
它的输入通常包括材料、问题和评价标准;输出是受约束的选择或数值
理解它的原理
- 它的任务只做判断,把任务直接写成一个判断
- 把校准作为训练目标之一
- 共享材料,并行评估多个小问题
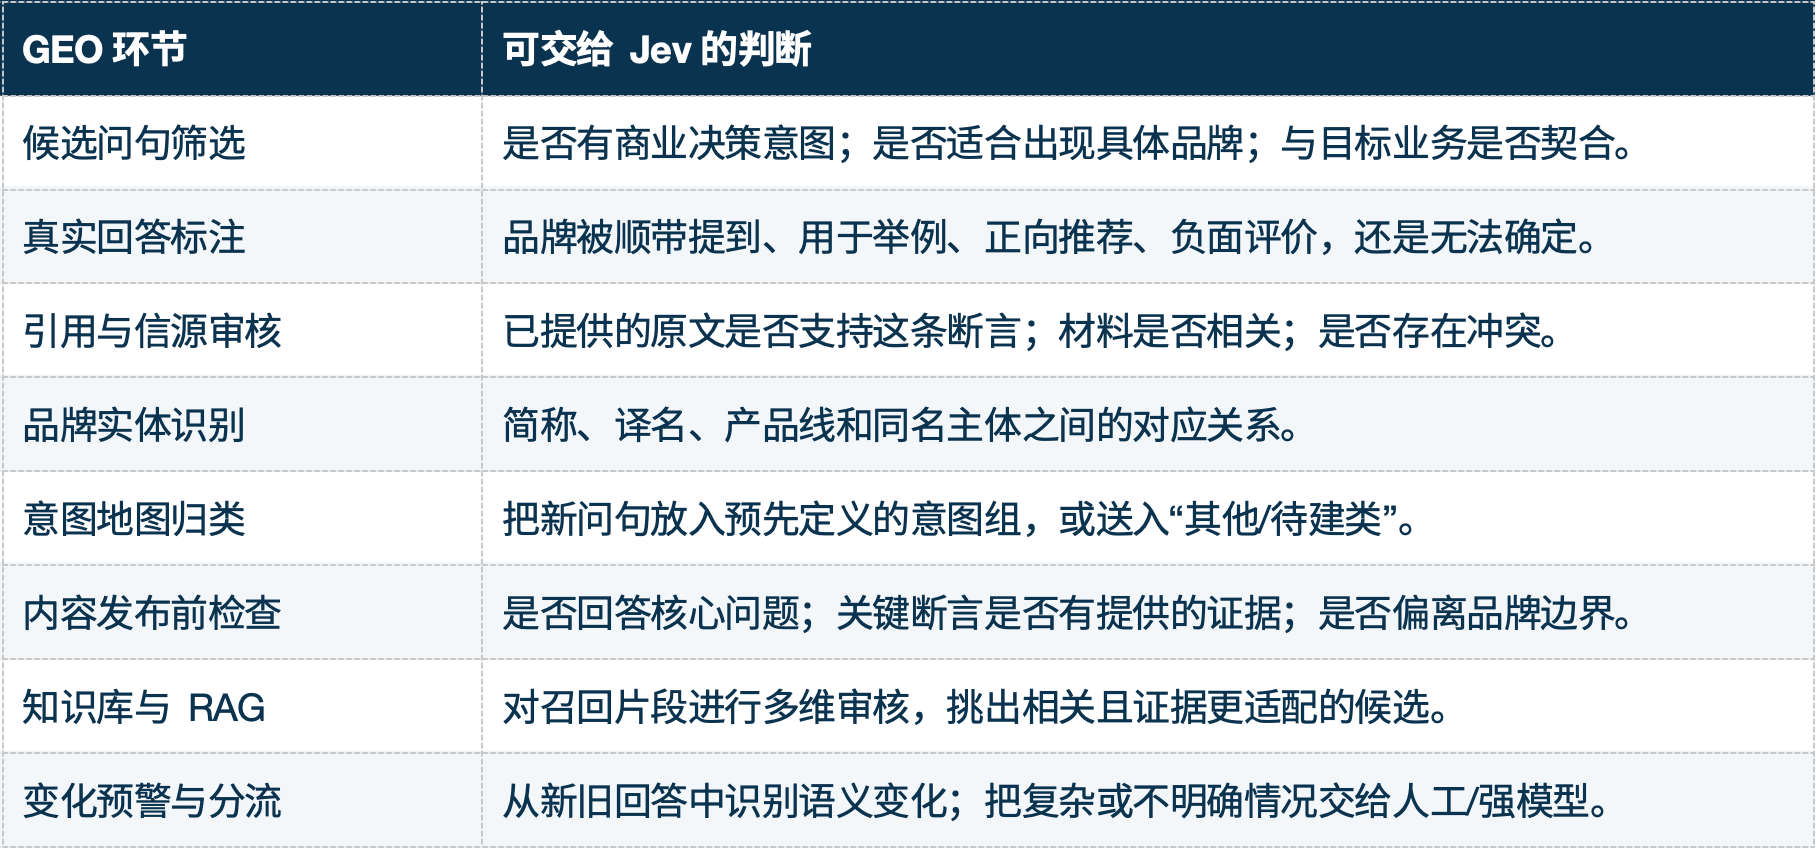
在GEO这个业务场景下,Jev可以帮助处理运营中产生的材料与判断任务,但接入一个评审模型,本身不会让搜索平台抓取、索引或引用某个网站,会极大的提升处理效率和降低成本
对GEO,它最直接的价值是辅助筛选、标注和核验,具体还需要进行对比测试
官网:typesafe.ai